부하 테스트
검증. SLO를 먼저 정하고 dev에서 stg까지 실측
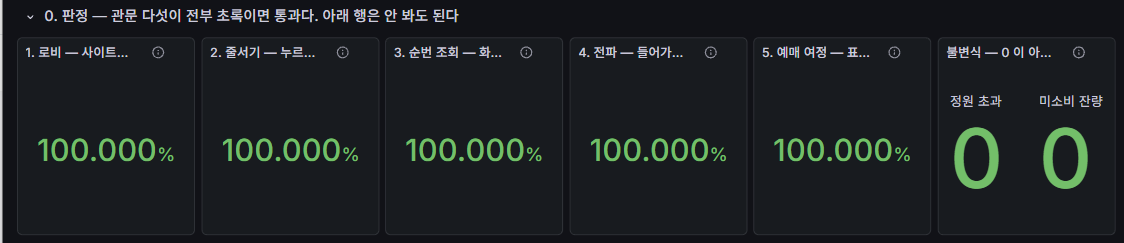
기준 사례는 2024년 한국시리즈 극장 생중계 예매 대기 16만 명이고, 목표는 10만 명입니다. 사용자 단계(첫 화면 → 대기열 진입 → 순번 조회 → 입장 → 예매)마다 SLO를 테스트 전에 확정하고, 같은 여정을 k6로 재현했습니다. 테스트마다 먼저 막힌 곳을 찾아 구조를 바꾸며 dev 1만 명에서 stg 5만 명까지 통과했습니다.
SLO, 테스트 전 확정
| 단계 | 성공 기준과 목표 | 이유 |
|---|---|---|
| 1 첫 화면 frontend | 응답 2xx, 99.9% | 실패하면 뒤 단계에 사용자가 오지 않아 다른 SLO가 통과처럼 보임 |
| 2 대기열 진입 queue, Redis, Kafka | 진입 요청 성공, 99.9% | 대기열의 역할이 전원 수용이라 가장 엄격 |
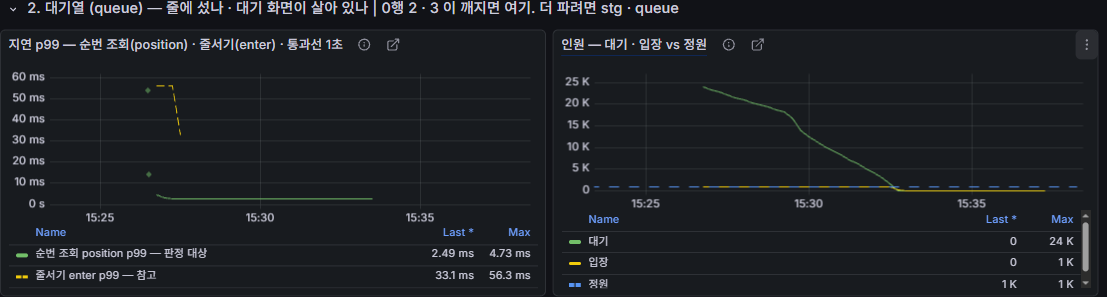
| 3 순번 조회 queue, Redis | 1초 이내 성공, 99% | 가장 짧은 갱신 주기가 1초라, 넘으면 대기 화면이 밀림 |
| 4 입장 반영 queue → Kafka → booking | 입장 후 1초 이내 booking에 반영, 99.9% | 반영 전 좌석을 누르면 거부(403)인데 요청 지표에는 실패로 잡히지 않음 |
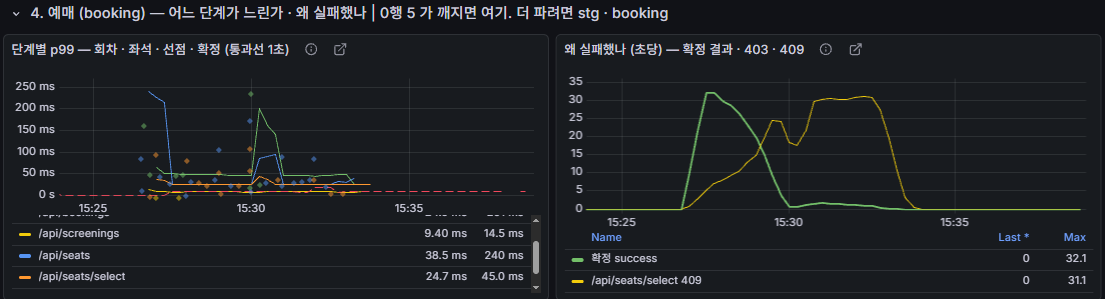
| 5 예매 여정 booking → Redis 선점 → MySQL 확정 | 회차, 좌석, 선점, 확정 각 1초 이내 성공, 99% | 확정만 세면 앞 단계 실패가 가려짐. 매진 응답(409)은 제외 |
- 목표값: 지연 기준 1초는 사람이 지연을 느끼는 선이고, 99.9%는 업계 표준선에서 시작한 초기값
- 불변식: 정원 초과 0, 처리하지 못한 입장 메시지 0, 5xx 0, 입장 후 거부(403) 0. 하나라도 어기면 무효
- 판정: k6가 아닌 서버 지표(Mimir) 기준으로, 예매 오픈 1분 전부터 5분 뒤까지. 매번 좌석 4,000, 대기 0에서 시작
결과, stg 1만과 2.5만, 5만 명
| 1만 명 | 2.5만 명 | 5만 명 | |
|---|---|---|---|
| SLO 5개 | 전부 100.000% | 전부 100.000% | 순번 조회 99.501%, 나머지 100.000% |
| 불변식 위반 | 0 | 0 | 0 |
| 입장 반영 최대 | 0.251초 | 0.401초 | 0.362초 |
| 최대 대기 인원 | 9,000 | 23,958 | 49,000 |
| 예매 여정 요청 | 29,519 | 46,208 | 45,468 |
- 예매 여정 요청은 대기 인원이 아닌 정원에 비례: 사용자가 5배(1만에서 5만)로 늘어도 1.54배이고, 동시 입장 정원 1,000이 상한
병목이 옮겨 간 순서
| 규모와 증상 | 원인 | 조치 → 결과 |
|---|---|---|
| dev 3만 명에서 k3s 재시작 | 사전 계산이 지목한 Redis는 CPU 44%였고, Traefik 동시 연결이 1만 명 458에서 3만 명 22,866으로 늘어 노드 메모리가 고갈 | 노드 RAM 8GB 3대가 한계라 부하 측정을 stg(EKS)로 이전 |
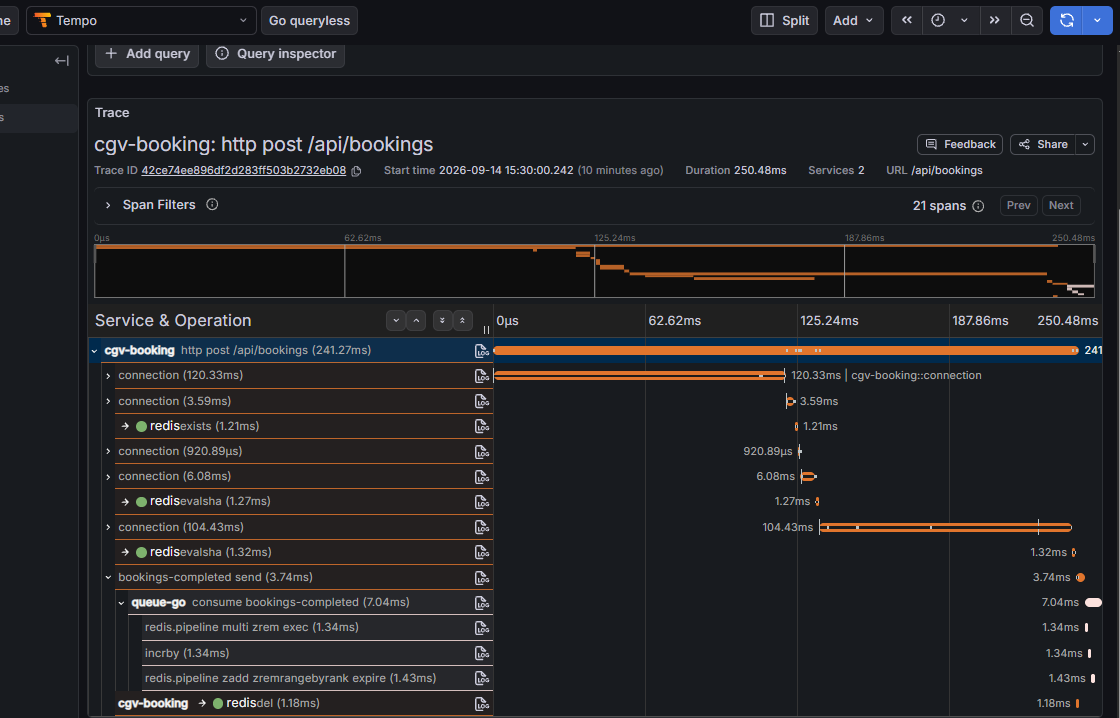
| stg 1만 명에서 예매 오픈 순간 입장 반영 최대 4.59초 | 새로 뜬 booking의 JVM 컴파일이 CPU를 117초 점유해, 같은 노드 Kafka 브로커는 CPU 경합 시 배분이 7% | booking 전용 노드그룹으로 브로커 CPU 보장 → 0.251초 |
| stg 2.5만 명에서 대기열 진입 1초 초과 10,197건 | 노드를 4대에서 3대로 줄여 queue 파드 2대가 한 노드에 몰림. CPU 차례를 기다리는 것이고 Redis는 여유 | 노드 4대에 파드 1대씩 분산 강제 → 0건 |
stg 3만 명에서 k6 connection reset 다발 | 부하 발생기 EC2 1대의 초당 패킷 한도. 초과 패킷을 오류 없이 폐기하고 서버는 여유 | 발생기 4대에 12,500명씩 분산 |
| stg 5만 명은 SLO 통과했으나 대기열 진입 1-2.5초 13,641건 | 요청은 4대에 같게 분배되는데 연결 수는 2대에 최대 27배라, 그 2대만 Redis 연결 풀에서 대기 | 미해결. 응답이 늦은 파드에 ALB 연결이 더 쌓이는 순환으로 추정 |
10만 명으로 가려면
- 사용자 수만큼 늘어나는 대기 요청은 queue와 Redis가 처리: 먼저 한계에 닿은 곳은 Redis 서버가 아니라 queue 파드당 동시 요청이었다(사전 계산은 두 번 다 Redis를 지목했고, 실측은 두 번 다 동시 연결). 여유가 가장 적은 SLO는 순번 조회(5만 명 99.501%, 목표 99%)
- queue 파드 수는 8대: 5만 명 실측(파드 4대, 파드당 약 12,500명, SLO 통과)의 파드당 인원을 10만 명에 적용. 여유분은 넣지 않음
- 파드 간 분산 방법은 별도 과제: 5만 명처럼 연결이 일부 파드에 몰리면 파드를 늘려도 같은 병목이다. 조정 대상은 ALB 분산 방식(처리 중 요청이 적은 파드 우선)과 파드당 동시 요청 상한이고, 확인은 ALB 접근 로그로
- 입장과 좌석 계산: 정원 1,000에 초당 최대 100명 입장이면 10만 명 전원 입장에 약 16분. 좌석 4,000은 실측상 입장 시작 약 80초에 소진되므로, 약 9만 6천 명은 성능이 아니라 제품 정책의 영역
한계
- 실측 상한 5만 명: 5만 명에서 파드당 부하와 다음 과제(파드 간 분산)를 확인한 뒤 AWS 크레딧 소진으로 종료. 10만 명은 계산으로 대체했고 분산 방법과 Redis 주 노드의 10만 명 부하는 확인하지 못함
- 장시간(soak) 테스트 없음: stg는 3일간 가동해 검증한 뒤 정리했고, 메모리와 커넥션 누수는 확인하지 못함
기술 스택
k6, Terraform(부하 발생기), Grafana, Mimir, Loki, Tempo