옵저버빌리티
관측. dev 감시와 stg 부하 테스트 판정
노드마다 Alloy가 metric과 log, trace를 모아 Mimir, Loki, Tempo에 저장하고 Grafana로 조회합니다. dev(온프레미스)와 stg(클라우드)에 같은 차트로 각각 구성했습니다. dev는 클러스터와 호스트 감시, 알림을 맡고 stg는 부하 테스트 판정용 대시보드입니다.
옵저버빌리티 구조
설계 결정
| 항목 | 선택 | 이유 |
|---|---|---|
| metric 저장소 | Mimir distributed. ingester는 dev 3대, stg 1대 | ingester가 1대면 그 중단 동안 metric 저장이 멈춤. dev는 3대 중 2대로 유지하고, stg는 테스트 기간 한정이라 1대 |
| log와 trace | Loki와 Tempo 단일 | log와 trace는 원인 조사용이라 수집 공백이 판정에 영향을 주지 않음. WAL로 재시작은 복구되고 노드 유실은 감수 |
| 원본 저장소 | dev는 MinIO 파드, stg는 S3(IRSA) | 노드 디스크에는 WAL만 두고 나머지는 오브젝트 스토리지에서 재생성. stg는 IRSA로 키 없이 접근 |
| dev 알림 기준 | 조치할 수 있는 것만 Discord로, 클러스터 밖 감시는 Better Stack | 물리 층은 재기동으로 회복되지 않고, 앱 지연은 임계 근거가 없어 제외. 클러스터 안 알림은 함께 중단됨 |
| stg 스택 | stg 안에 같은 차트로 별도 구성하고 집으로 전송하지 않음 | 집 Mimir 활성 시리즈가 상한의 91.8%라 stg 시리즈를 받을 수 없음 |
| stg 판정 대시보드 | 4개 새로 구성. 흐름, queue, booking, 데이터. queue만 5초 수집 | dev 대시보드는 Traefik과 파드 DB를 전제해 stg에서 행 절반이 빔. 오픈 순간 급증이 15초 수집 간격 안에 끝남 |
트러블슈팅
| 증상 | 원인 | 조치 |
|---|---|---|
| dev 활성 시리즈가 상한 15만에 도달. 오류 표시 없이 metric 값만 누락 | k3s는 :6443과 :10250이 같은 프로세스라, 둘 다 수집하면 중복 metric이 상한 15만의 85%를 차지 | :6443 수집을 제거하고 상한을 30만으로 올려 초과 거절 0 |
| dev 호스트 유휴 CPU 92°C. 예고 없는 전원 차단 이력이 있는데 온도 기록이 없음 | 온도와 전원은 물리 호스트 metric이라 VM 안에서는 수집 경로가 없음 | 호스트 node-exporter와 쿨러 조정으로 66°C, 알림은 90°C |
| stg 2.5만 명 입장 반영 97.445%. 브로커는 유휴인데 메시지 대기 1.852초 | 폴링(요청의 96%)마다 접근 로그가 1줄씩. Loki 초당 4,256줄, 수집기가 노드당 0.5코어, booking 노드 런큐 3.30초/초 | 성공 폴링 로그를 제외해 100.000%, 741줄/초, 런큐 0.26 |
결과
- dev와 stg에 같은 차트로 관측 스택 구축: 수집과 저장, 대시보드, 알림 규칙 전부 코드(cgv-infra)
- dev에서 클러스터와 호스트 상태 확인: 클러스터 대시보드로 노드 CPU와 메모리, 문제 파드를 식별. 호스트(노트북 Proxmox)는 과열과 전원, 디스크 이상을 Discord로 알림
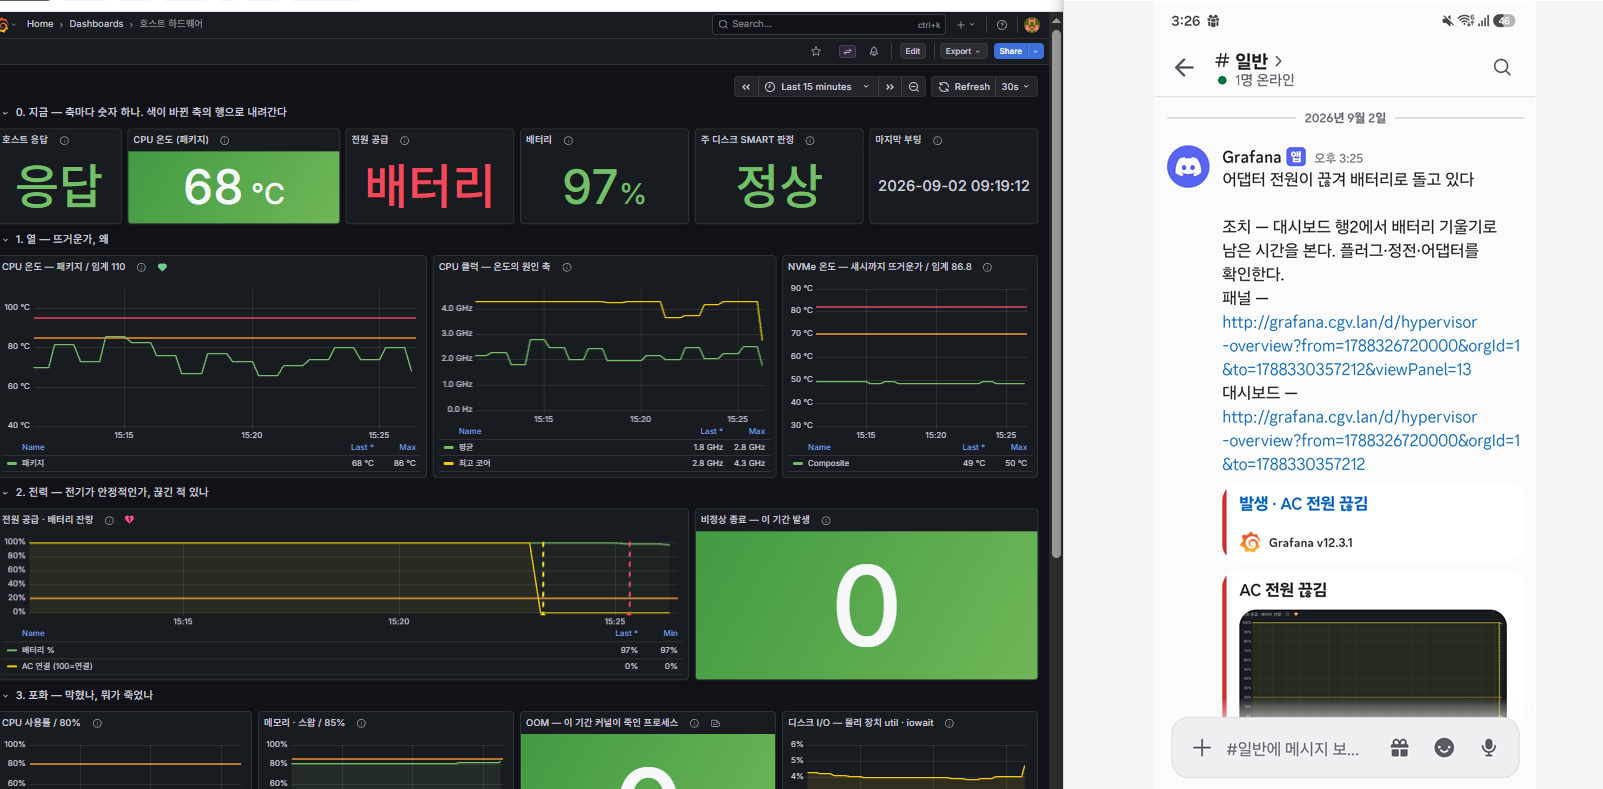
- stg에서 앱 서비스 흐름 대시보드로 부하 테스트 판정: 입구에서 대기열, Kafka 전달, 예매 순서로 막힌 곳을 확인. 결과는 부하 테스트
한계
- 실 서비스(prd) 관측 경험 없음: 대시보드는 dev 현 상태 확인과 stg 부하 테스트용까지 구축
기술 스택
Mimir, Loki, Tempo, Grafana, Alloy, MinIO, S3, CloudWatch exporter, kube-state-metrics, node-exporter, Better Stack