LevelDB 캐시 메커니즘 분석
C++ 소스 분석과 캐시 파라미터별 읽기 성능 실측. KSC 2022 학부생 논문 1저자
단국대학교 시스템 소프트웨어 연구실 학부 연구생(2022.07 - 12). Google LevelDB는 LSM-tree 기반으로, 읽기 성능이 캐시 두 계층에 좌우됩니다. 두 캐시가 LRU 엔진 하나를 공유하는 구조를 C++ 소스로 분석하고, 캐시 파라미터별 읽기 지연을 실측했습니다.
캐시 구조, 소스에서 확인한 것
읽기 경로
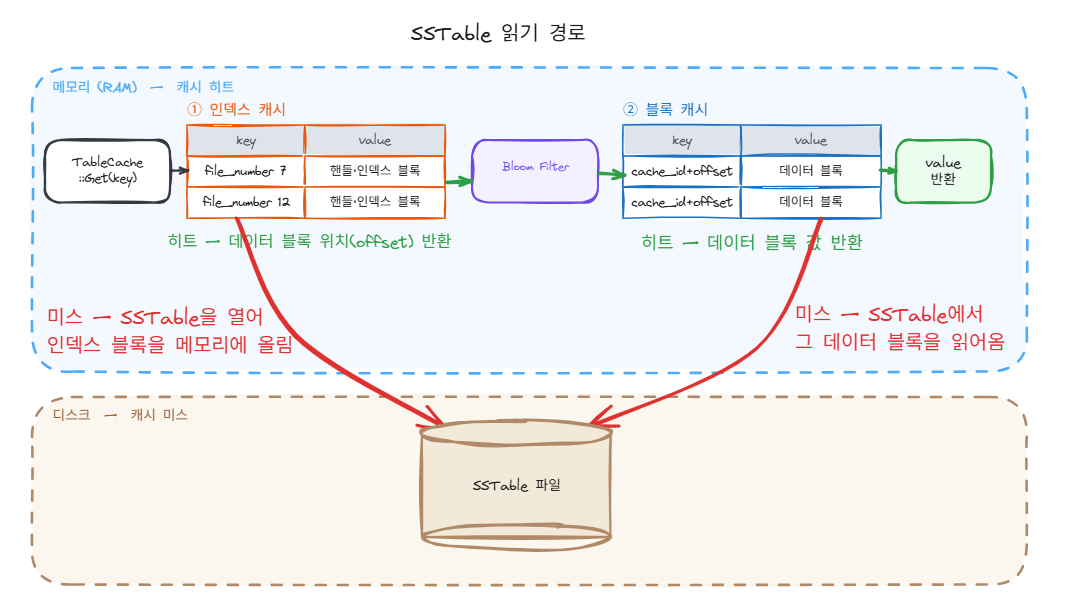
- 인덱스 캐시: key는
file_number, value는 인덱스 블록. 히트 시 데이터 블록 위치(offset) 를 반환하고, 미스 시 SSTable을 열어 인덱스 블록을 적재. 용량 단위는 개수(파일 수) - 블록 캐시: key는
cache_id + offset, value는 데이터 블록. 히트 시 값을 즉시 반환하고, 미스 시 SSTable에서 블록을 읽어 적재. 용량 단위는 바이트이고,cache_id가 여러 SSTable의 같은 offset 충돌을 막음
LRU 엔진
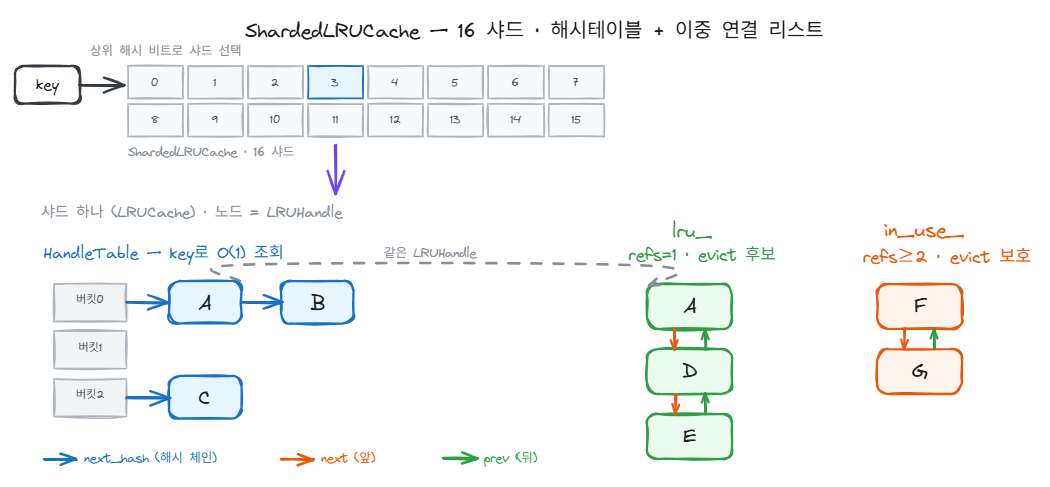
- 16개 샤드에 샤드별 독립 락: 락이 하나면 모든 조회가 순차로 대기하고, 샤드로 나누면 다른 키는 동시에 조회
- 노드 하나로 조회와 순서 관리: 같은
LRUHandle을 해시테이블과 이중 연결 리스트에 함께 연결해, 조회와 순서 갱신 모두 복사 없이 O(1) refs로 use-after-free 차단: eviction 대상은lru_(refs=1)뿐이고,in_use_(refs 2 이상)의 사용 중 블록은 해제하지 않음
설계 결정
| 항목 | 선택 | 이유 |
|---|---|---|
| 독립 변수 | 인덱스 캐시 개수와 블록 캐시 크기를 한 번에 하나씩 | 둘을 같이 바꾸면 어느 쪽 효과인지 분리할 수 없음 |
| 워크로드 | readrandom, seekrandom, readhot | 워킹셋이 다른 셋. 전체 key 무작위, 전 레벨 탐색, 1%만 반복 |
결과
환경은 EC2 t2.micro, key 16B, value 100B, fillrandom 100MB.
| 변수 | readrandom | seekrandom | readhot |
|---|---|---|---|
| 인덱스 캐시 개수 0 → 10,000 | 190 → 75μs | 275 → 110μs | - |
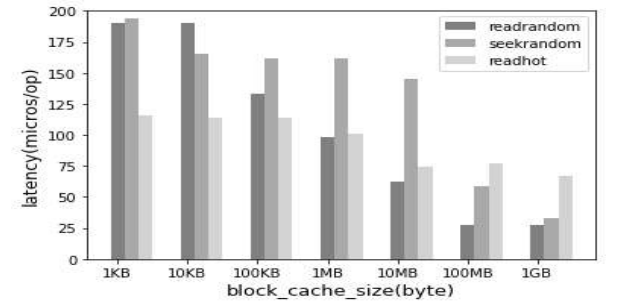
| 블록 캐시 크기 1KB → 1GB | 190 → 27μs | 195 → 33μs | 115 → 65μs |
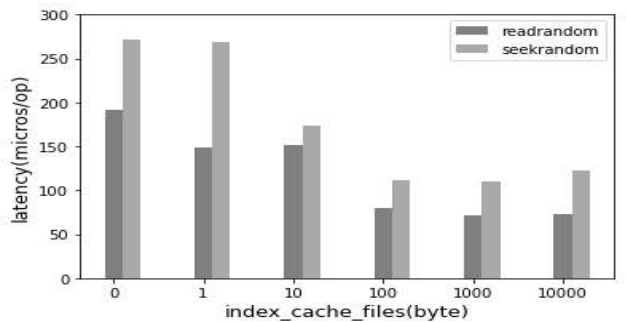
- 인덱스 캐시는 100개에서 포화: 실험 데이터의 SSTable이 100개 이하라 추가로 캐싱할 인덱스 블록이 없음
- 블록 캐시 효과는 워킹셋에 비례: seekrandom은 100MB를 넘어야 급락하고, readhot은 1KB에서 이미 낮아 개선 폭이 작음
- KSC 2022 학부생 논문 1저자 게재와 포스터 발표
포스터 발표 현장
한계
- t2.micro 단일 인스턴스 실험: 멀티노드와 대용량 환경의 캐시 거동은 검증하지 못함
- 16개 샤드 간 부하 균등 분배 미확인: 논문 후속 과제로 남김
기술 스택
C++, LevelDB, db_bench, AWS EC2