semiai 옵저버빌리티
k3s 클러스터와 Go, Python 앱의 옵저버빌리티. LGTM 스택 구축과 계측, 대시보드, 알람
반도체 수율 AI 플랫폼 회사 인프라팀(2026.03 - 06). 개발자만 쓰는 dev 클러스터(EC2 4노드 k3s)에 LGTM 관측 스택을 구축하고, Go 백엔드와 Python 게이트웨이 계측, 대시보드 3종, 알람을 맡았습니다.
배경
- 클러스터: docker-compose에서 k3s로 전환. 관측은 CloudWatch 노드 지표뿐이라 클러스터 상태를 매일 점검할 대시보드가 필요했습니다.
- 앱: 개발팀 요구는 서비스 지표와 로그를 Grafana에서 보는 것. 그때까지 사고 대응은 로그 검색이었고, 목표는 사고 인지부터 코드 위치 식별까지 1분 안입니다.
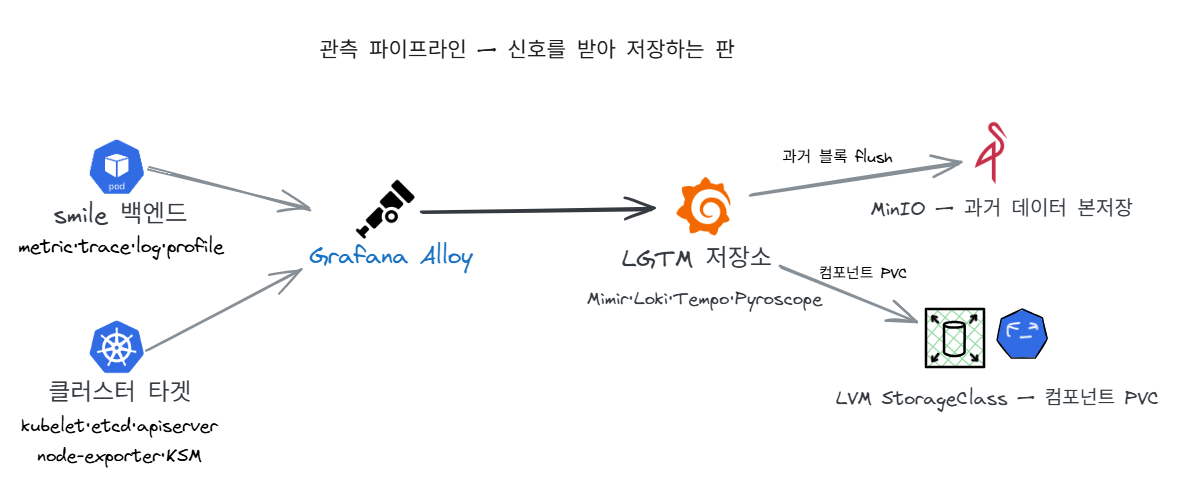
옵저버빌리티 구조
설계 결정
클러스터 대시보드
| 항목 | 선택 | 이유 |
|---|---|---|
| 점검 틀 | 현재 상태와 조회 범위 안의 이상 기록. 회복한 뒤에도 행이 남고 마지막 발생 시각을 표시 | 인프라 알람 없이 매일 점검하므로, 점검 전에 회복된 이상을 놓치지 않게 |
| 비정상 Pod 판정 | ready=false 하나. 여부는 지표로, 이유는 Loki 이벤트와 컨테이너 로그로 | 실패 유형 6종을 OR로 묶으면 조건이 늘수록 설명과 신뢰가 떨어지고, 원인 문구는 지표에 담기지 않음 |
앱 계측과 대시보드
| 항목 | 선택 | 이유 |
|---|---|---|
| 계측 위치 | 미들웨어와 공통 에러 진입점. 도메인 코드에 계측 호출 0 | 에러 처리가 한 함수로 모여 metric, span 속성, 로그, 응답이 거기서 생성 |
| 오류 축 | HTTP status 축과 도메인 에러 코드 축 | 업무 규칙상 거부된 요청은 200으로 응답해 status 축에 안 보임 |
| trace 연결과 알람 기준 | exemplar(trace 표본) 대신 path 패널 링크, P99 대신 건수, 비율 대신 절대 건수 알람 2개 | dev 표본이 적어 대표 1건과 분위수, 비율이 무의미. exemplar는 구현 후 제거 |
| trace에서 profile로 | Start time -60초/+5초 패널 링크와 profile 라벨에 trace_id 부착 | Grafana 표준 기능이 없음. heap은 라벨이 남지 않아 시각 창으로, CPU와 goroutine은 trace 1건 매칭 |
| 패널 설명 | 패널마다 목적, 정상, 임계, 조치, 주의 | k8s와 LGTM을 모르는 개발팀이 대시보드만으로 진단 |
트러블슈팅
| 증상 | 원인 | 조치 |
|---|---|---|
| master 2대를 정지했는데 노드와 etcd 패널은 정상 | 노드는 kube-state-metrics 경유 값, etcd는 apiserver 쪽 지표라 둘 다 감시 대상과 함께 멈춤 | kubelet 직접 수집 값과 etcd 자체 지표로 교체, 재정지 시 빨강 확인 |
| 개발자는 502를 보는데 앱 metric엔 5xx 없음 | 502와 503은 Traefik에서 발생하는데, 기본값이 metric 포트를 노출하지 않아 수집이 안 됨 | 포트를 노출하고 ServiceMonitor를 작성해 502, 503 수집 |
| backend Pod 반복 OOMKilled로 502, 503 | ClickHouse 조회 함수 하나가 대량 데이터를 로딩하며 파드 메모리 점유 | profile로 메모리 점유 함수를 특정해 팀에 시연, 개발팀 수정으로 해소 |
| span에서 로그나 profile로 이동하면 No data | 서비스 이름이 저장소마다 다르고, OTLP 로그가 Alloy 출력에 연결되지 않아 폐기됨 | 서비스 이름 통일(환경 변수와 relabel), Loki exporter 연결로 trace_id 로그 조회 확인 |
| panic 요청이 status 0으로 집계 | 미들웨어 순서 문제로 복구(Recovery)가 로깅 안쪽이라 status 확정 전에 기록 | 순서를 교체하고 metric 기록을 defer로 |
결과
- LGTM 스택 구축과 ArgoCD 배포: Mimir, Loki, Tempo, Pyroscope와 Alloy. 장기 저장은 MinIO, PVC는 LVM StorageClass
- 대시보드 3종과 알람 2개: 클러스터 점검 19패널(인프라팀), 앱 진단 5행, 프로파일링(개발팀). panic과 gateway error 알람을 Teams로
- 관측 사각 2건 제거: 앱 metric에 없던 게이트웨이 502, master 정지에도 정상으로 표시되던 노드와 etcd 상태
- OOMKilled 원인 함수 특정: profile로 찾아 팀에 시연, 개발팀 수정으로 해소
- 앱 4축 계측: Go의 metric, trace, log, profile과 Python trace 전파. 도메인 코드에 계측 호출 0
한계
- 개발자만 쓰는 dev: 실 서비스 트래픽 관측과 실제 사고 대응 기록이 없음(재현 시험까지)
- 미검증: 계측한 서비스 둘 중 하나만 배포, 게이트웨이에서 백엔드로 이어지는 단일 trace 미확인, 앱 계측의 클러스터 배포 검증 미수행(CI/CD 구축 전)
- etcd 쿼럼 손실 시 상태값 정지의 메커니즘 미검증: 관찰과 재현까지
기술 스택
k3s, Grafana, Mimir, Loki, Tempo, Pyroscope, Alloy, OpenTelemetry, kube-state-metrics, node-exporter, MinIO, LVM, SealedSecret, ArgoCD, Helm, Traefik, Go, Python(FastAPI), Azure DevOps